前置知识 : Transformer 笔记; VIT(了解原理/代码); Contrast Learning(了解原理)
CLIP
Contrastive Language-Images Pretraining
从名字可以看出
- 采用的是对比学习
- 是一个多模态模型 有语言和图片
- 预训练模型 适配别的下游任务
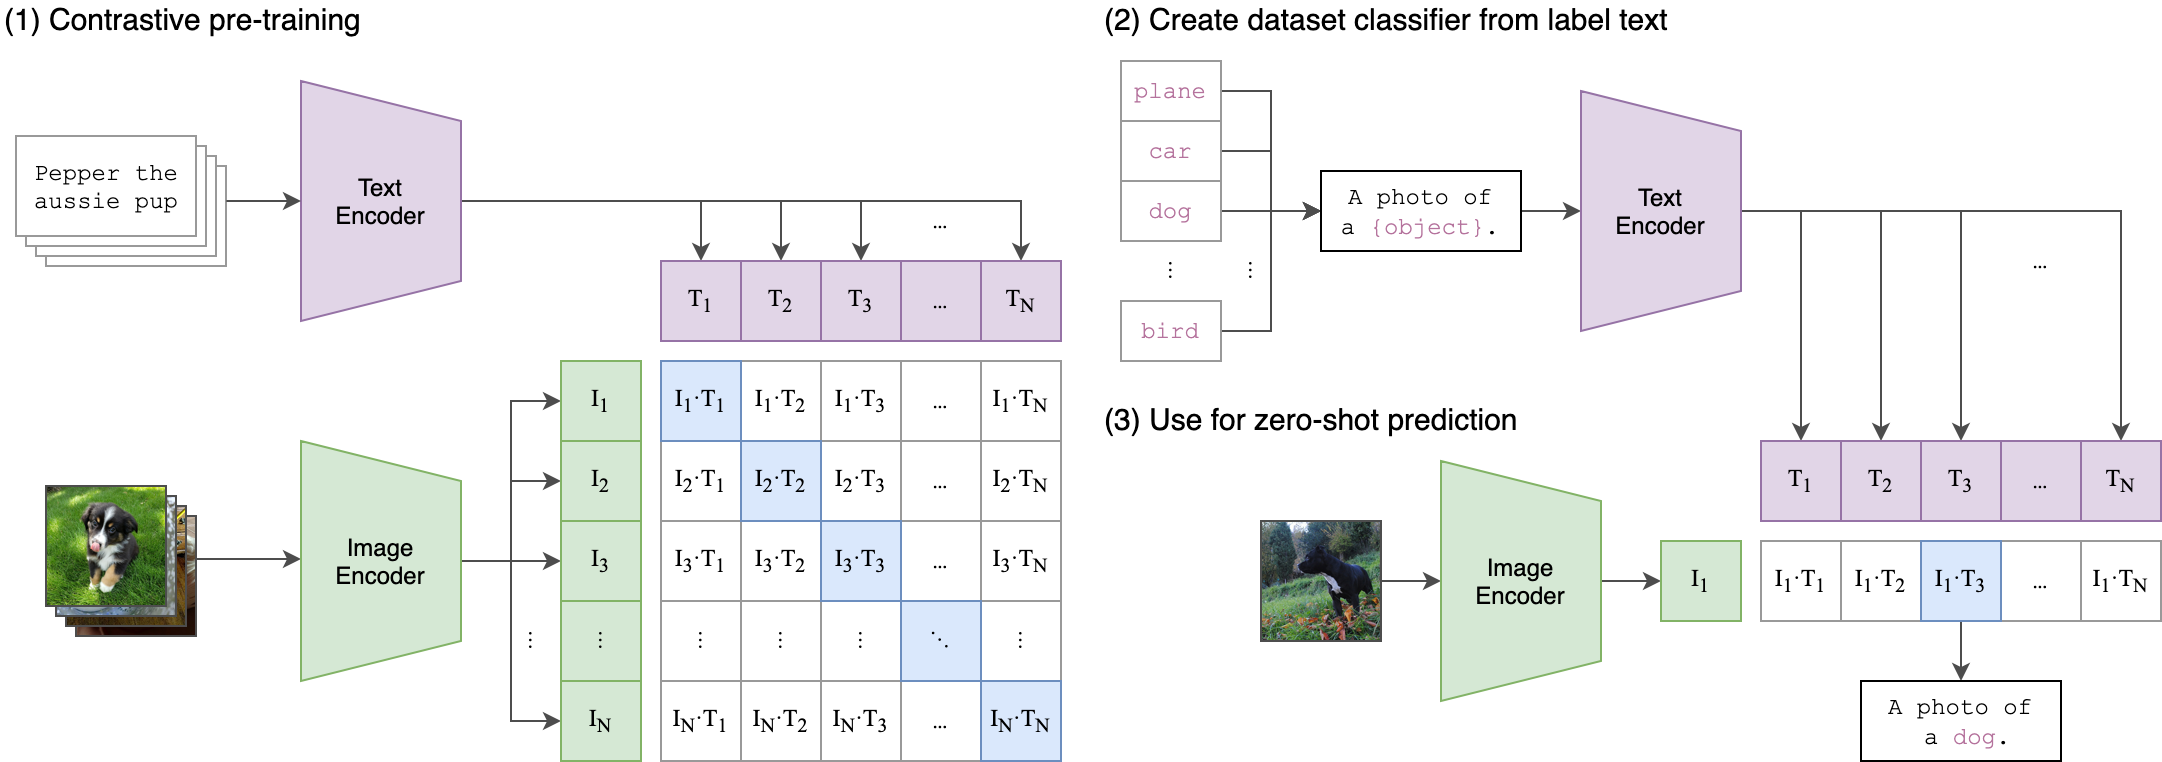 简单讲解一下原理吧 (更好的阅读体验Bilibili: BV1SL4y1s7LQ).
图一就是完整的训练过程 : 首先我们的训练数据 是图片和文本对, 如图我们一个输入了N个图片文本对
图片经过image encoder(通常是vit) 然后得到了 N个图像特征
文本经过transformer 然后得到了N个文本特征
那么我们就可以得到一个 [N,N] 的矩阵,那么很明显(I_i,T_i) 是正样本,因为他们属于同一个图片样本对, 其余的 N * N - N个都是负样本,我们的目的就是让配对的图像和文本在各自的语义空间尽可能靠近,而其他的远离。 补充一些说明 : CLIP的数据集有400M对数据,都是从网上爬下来的。 CLIP是一个弱监督模型 (GT就是配对的文本对)
一些实现细节
Model parameters: 151,277,313  (0.15B)
Input resolution: 224
Context length: 77
Vocab size: 49408
tokenize仍然是经典的subword BPE 实现inTransformer 笔记
- Text Encoder(通常是 Transformer)→ 提取文本的语义信息 直接调用nn.MultiheadAttention即可
self.attn = nn.MultiheadAttention(d_model, n_head)  ## 定义框架
self.attn(x, x, x, need_weights=False, attn_mask=self.attn_mask)[0] ## 调用的时候要传q,k,v 因为要确定是self-attention还是cross-attention
MLP的中间激活层是QuickGELU (这个当时是为了加速,但是GELU用tanh拟合其实也挺快的,可以看一下官方实现) Preprocess过程 这里的bicubic是双三次插值,可以看我的另一篇blog有解释(但其实不太需要原理,只需要知道效果最好 + 计算最慢 :))
Compose(
    Resize(size=224, interpolation=bicubic, max_size=None, antialias=True)
    CenterCrop(size=(224, 224))
    <function _convert_image_to_rgb at 0x1572bdd30>
    ToTensor()
    Normalize(mean=(0.48145466, 0.4578275, 0.40821073), std=(0.26862954, 0.26130258, 0.27577711))
)
- Image Encoder(ViT-L 或 ResNet)→ 但是经过测试ViT的效果更好,作者也测了用EfficientNet加强的ResNet(ViT的训练速度其实比ResNet快)
两个编码器的输出先各过一次线性投射,映射到同一维度的嵌入空间,再做 L2 归一化 [B,in_feature] 在做归一化之前,两个tensor的shape都是一样的,然后我们做L2归一化 x_i / sqrt(sum(x_i))
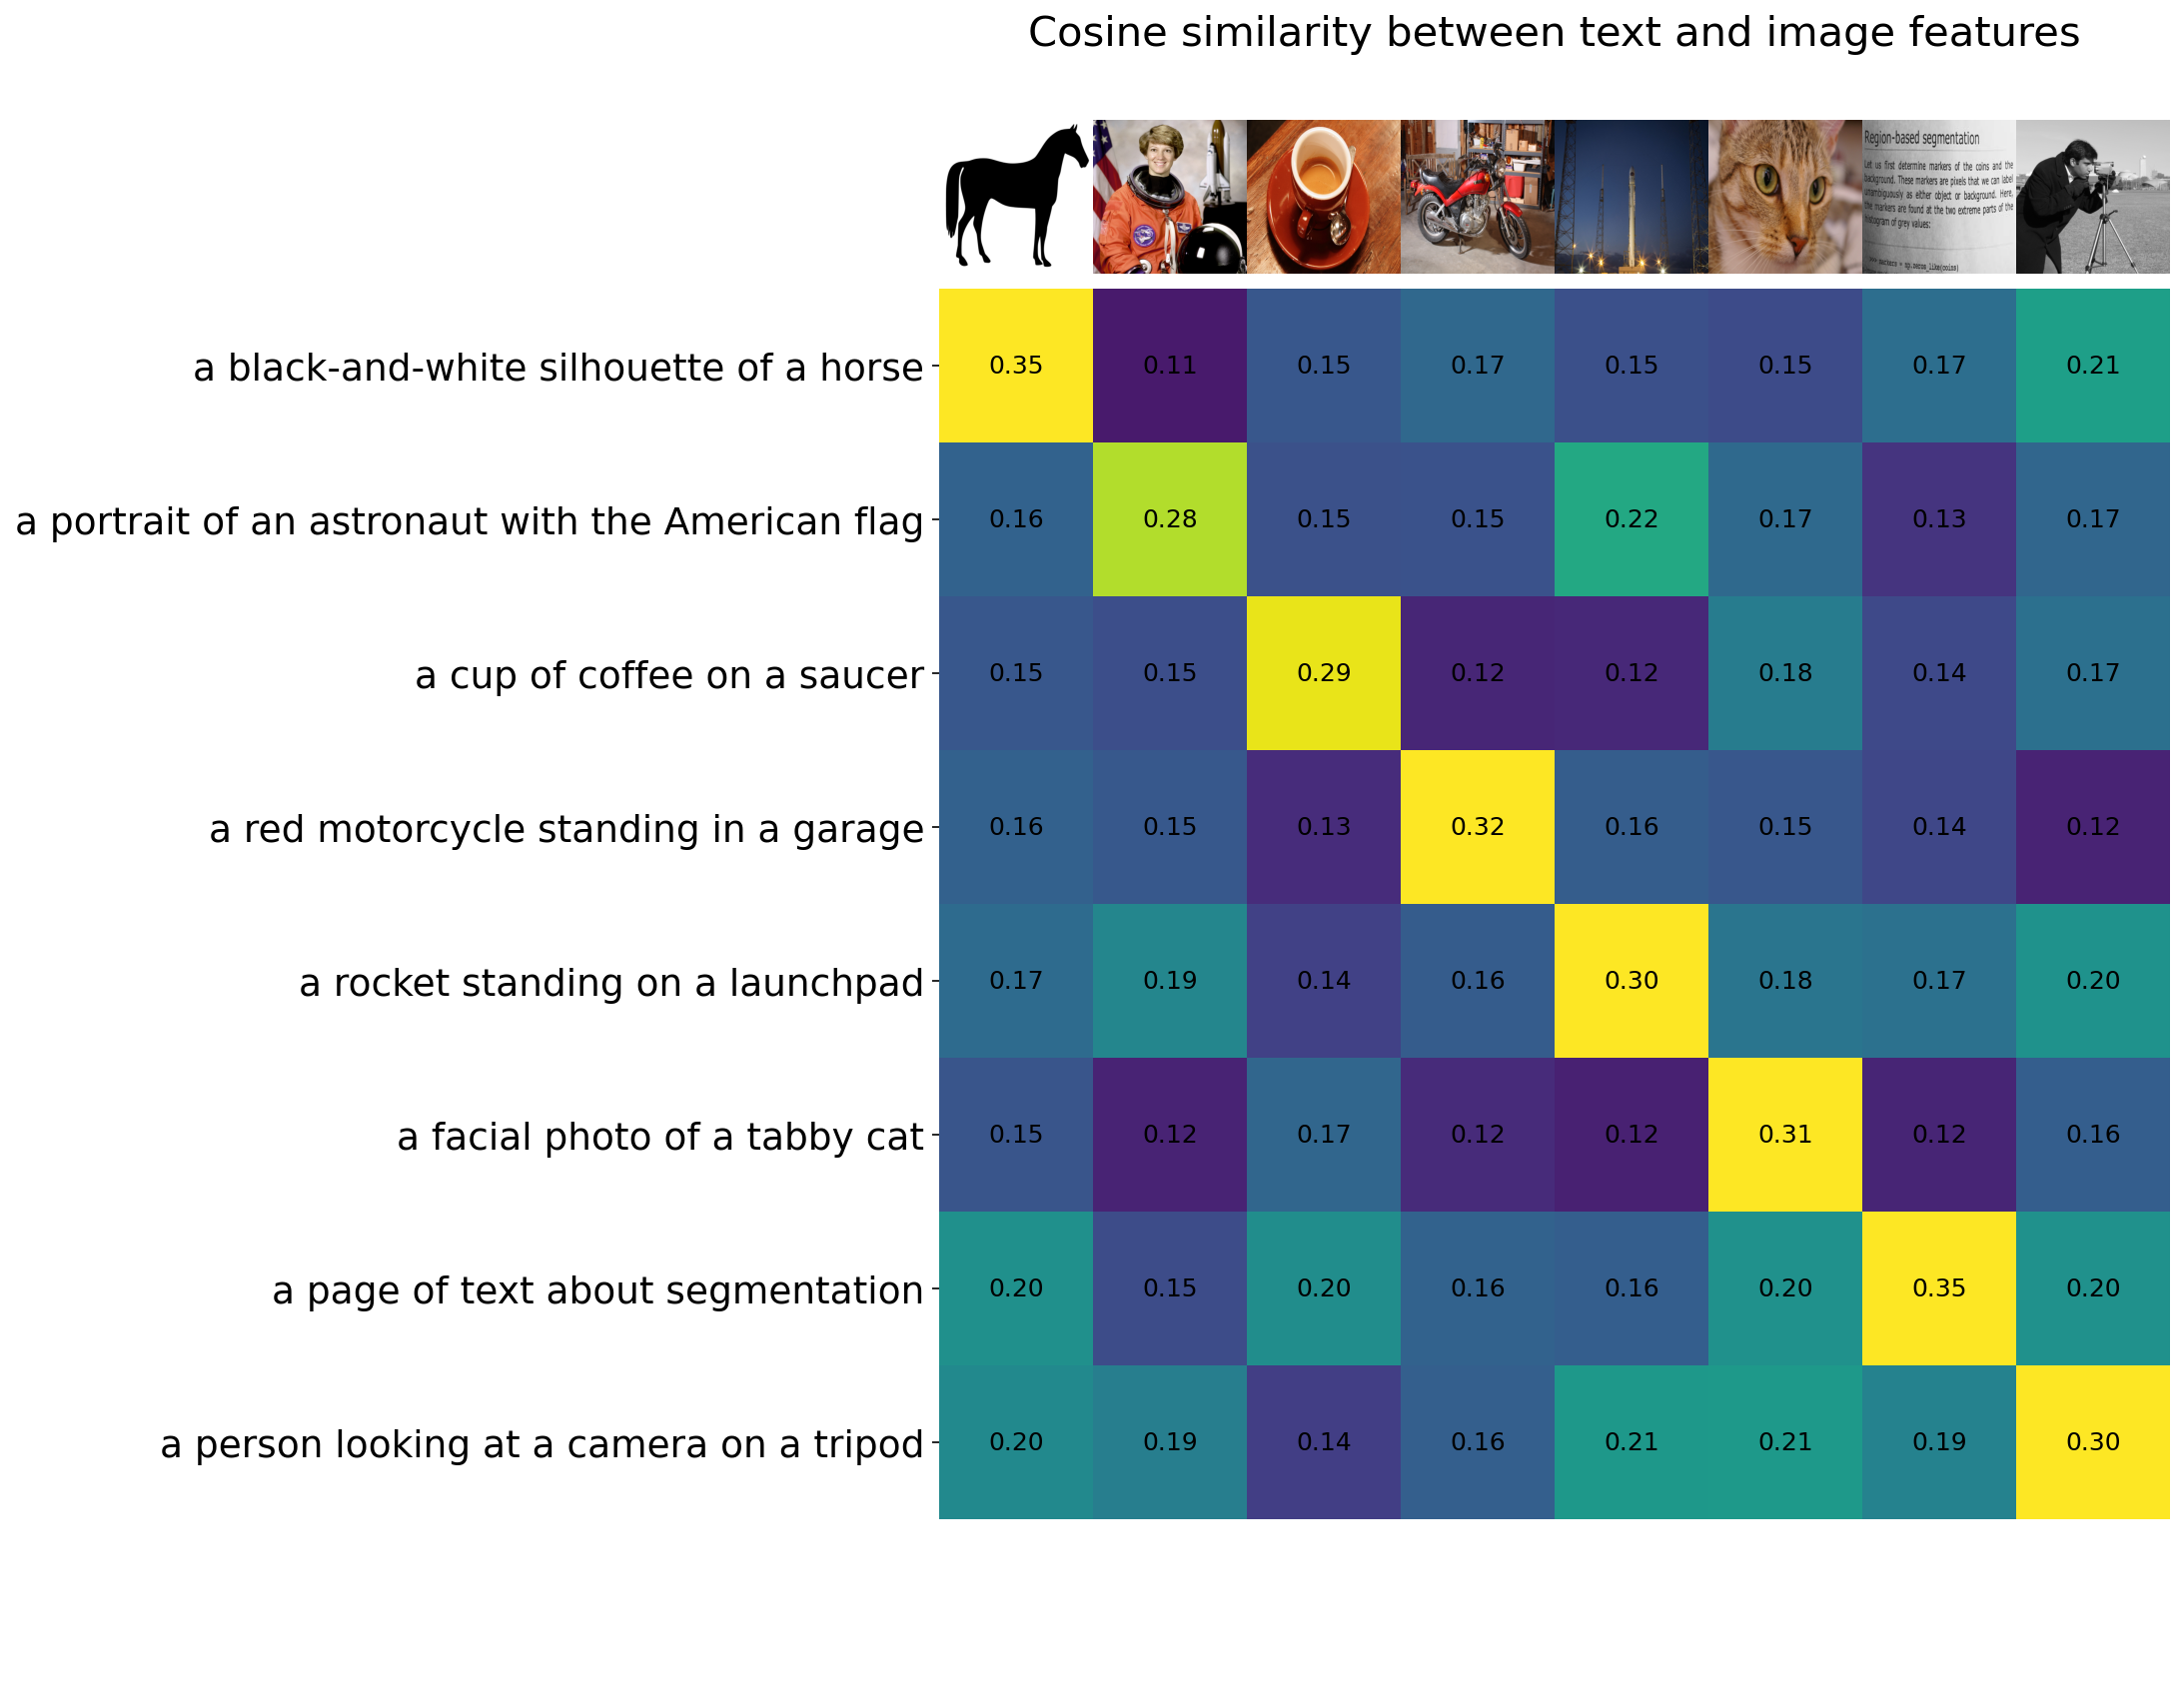
相似度矩阵 = image_features @ text_features.T # shape: [n, n]
然后clip因为训练量太大 将temperature也作为参数进行训练了,最后大概是T = 0.07,这样的话最大值会被凸显出来 得到一个 $n \times n$ 的相似度矩阵:
- 对角线上的 $n$ 个元素是正样本对(图配自己的文)
- 其余 $n^2 - n$ 个元素全是负样本
 Loss 是对称交叉熵:
- 沿着行方向算一个分类 loss——给每张图找正确的文本
- 沿着列方向也算一个——给每段文本找正确的图
- 两个方向取平均
clip的官方实现代码非常简单,所以在看完代码跑完demo会有更好的理解
CLIP 为什么能做零样本分类
CLIP 学的不是「这张图属于哪个类别」,而是**「哪段文字跟这张图更配」**。在刚才说的feature space对齐 它没有 class 这个概念,只是在语义空间中找最对齐的匹配对。
具体流程:
- 把所有候选类别做成 prompt:
"a photo of {class}" - 每段文本过 text encoder → 文本特征
- 图像过 image encoder → 图像特征
- 算图像与所有文本的余弦相似度
- 选相似度最高的那个类别 可以看一下clip 的github官方的那个CIFAR100 的例子 没有「没见过这个类」的问题——只要类名能写成文本,CLIP 就能匹配。
CLIP 的 limitation
- 抽象概念——「公平」「正义」这类无法用图片直观表达的概念,CLIP 匹配不了
- 训练分布外的数据——比如 MNIST 手写数字(4 亿训练数据里缺少这种分布)
- 拼写/字符级理解弱——CLIP 对单个字母、文字拼写的分辨力很差,因为它的 patch embedding 粒度不够细
那么我们必须明确的是CLIP是一篇2021年的论文,它最大的vit/14 也就只有300M的参数, 而现在的LLM大家了解的都知道至少都是7B,后文要讲的LLaVa 7B就是用CLIP作为它的image encoder,那么一方面说明视觉编码器占LLM很少参数,也说明了CLIP的能力不够(参数决定能力是大部分的情况)
那么CLIP除了上面说的limitation(论文在2021的sight)还有哪些呢 ?
首先它不支持动态分辨率, 对于任何分辨率的图片我们都是同一套preprocess, 处理成224 * 224 或者是 336 * 336的size, 这样的话我们分配给他们的token都是一样的,高分辨率的图片的信息太容易丢失了
还有就是确实参数量太小了
现在的一些open source的视觉编码器有SigLIP2 QWen-Vit等
SigLIP
那么现在我们来说一下SigLIP系列的工作, 首先Sig + Clip 这个模型用到了sigmoid函数作为损失函数, 其他基本没有什么变化
我们知道原来的clip用的是行 + 列的softmax, 那么就需要大量的batch_size 才能区分出正样本和负样本的差别, 而需要很强的工程能力 不好做lora微调适配新的dataset或者是任务.
SigLIP 采用的loss function是sigmoid函数所有的[B, B], B * B 个独立的样本, 每一个分别做sigmoid 取mean.
SigLIP2
SigLIP2 是
LLaVa
之前关于LLaMa的内容我已经在Transformer里面做了一些解释, 这里对llm的基础做一些基本的解释.
LLaMa 是一个简单的开源单模态lm, LLaVa是加入了图片模态的多模态lm
绝大多数的llm的推理都是next token prediction, 而之前的output都是作为prompt输入到模型中的
LLM 基础:next token prediction
LLM 的核心能力只有一个:next token prediction(下一个 token 预测)。但训练和推理时的行为不同,分开来看。
训练时:有完整序列(已知答案),每个位置都预测下一个 token,和真实值对比算 loss。
已知序列: [t1,  t2,  t3,  t4]   ← 训练数据给好了,答案已知

  位置1    位置2    位置3    位置4
   t1       t2       t3       t4       ← 输入(同时作为预测目标)
   ↓        ↓        ↓        ↓
[embed]  [embed]  [embed]  [embed]    ← embed_tokens 查表
   ↓   →    ↓   →    ↓   →    ↓
  Causal Attention(每个位置只看自己及左边)
   ↓        ↓        ↓        ↓
  [h1]     [h2]     [h3]     [h4]
   ↓        ↓        ↓        ↓
  softmax  softmax  softmax  softmax
   ↓        ↓        ↓        ↓
 预测 t2  预测 t3  预测 t4  预测 t5   ← 每个位置预测**下一个**
   vs       vs       vs       vs
  真实t2   真实t3   真实t4   真实t5   ← CrossEntropyLoss,loss 来自所有位置
推理/生成时:只有前缀,每步只用最后一个位置的输出去采样下一个 token。
第1步: 输入 [t1, t2, t3]
       t3 位置的 causal attention 能看到所有前文(t1→t2→t3)
       → 产出 [p1, p2, p3](3个概率分布)
       → 丢弃 p1,p2,只用 p3 采样 t4
       (p3 里已经包含了 t1,t2,t3 的完整上下文)

第2步: 输入 [t1, t2, t3, t4]
       t4 能看到 t1,t2,t3,t4
       → 丢弃 p1~p3,只用 p4 采样 t5

第3步: ... 重复,直到 EOS 或达到最大长度
训练 vs 推理总结
训练:一次前向,所有位置算 loss。效率高(并行)。
推理:一次前向只产出一个新 token。重复直到结束(自回归)。两个模式的 Transformer 计算完全一样。区别只在于:
- 训练的输入是完整序列(teacher forcing)
- 推理的输入每次增长一个 token(autoregressive)
为什么推理时前面的位置不重用? GPU 有 KV cache。第 2 步的 t1,t2,t3 对应的 K,V 已经在第 1 步算过了不用重算。只有新 token t4 需要算 attention。所以每步实际只做一次新的 token embed + causal attention。
「只用最后一个」 指的是取最后一个位置的输出分布去采样,但这个分布本身已经看过前面所有的 token——不是只看了前一个。
预训练(pretraining)vs 指令微调(instruction tuning)
| 预训练 | 指令微调 | |
|---|---|---|
| 干什么 | 学会「语言本身」 | 学会「听指令回答问题」 |
| 数据 | 海量互联网文本 | 精心构造的问答对 |
| 输入 | 任意文本(维基、代码、论坛…) | 格式化的指令文本 |
| 例子 | “巴黎是法国的首都。伦敦是…"(续写) | “USER: 法国首都是哪? ASSISTANT: 巴黎”(问答) |
| loss 计算 | 所有 token 都算 loss | 只在回答部分算 loss |
预训练完的 LLM 只会「续写」,不会「回答」。你跟它说「你好」,它续写十行废话。指令微调就是教它:看到 USER 那段 → 你应该输出 ASSISTANT 那段。
预训练和指令微调的训练代码逻辑完全一样,都是 next token prediction。区别只在数据格式和 loss 计算范围。不是两个不同的算法,是同一算法喂不同数据。
Conversation 模板
为什么需要模板
LLM 只会续写。你要它回答「法国的首都是哪?」,你得把这个问题伪装成它续写过的格式:
没有模板: "法国的首都是哪?"
LLM 看到的: 突然出现一句话,不知道该干嘛 → 乱续写

有模板:   "USER: 法国的首都是哪? ASSISTANT:"
LLM 看到的: 哦这是对话格式,USER说完该ASSISTANT说了 → 续写"巴黎"
模板做的事就是给 LLM 一个格式锚点,让它知道「现在该我说话了」。本质上就是 prompt engineering 的工程化。
USER / ASSISTANT 角色
Conversation 模板定义了两个角色:
| 角色 | 含义 | 训练时 loss? |
|---|---|---|
USER | 人类用户 | 不计算 |
ASSISTANT | AI/模型自己 | 计算 |
system | 系统级提示(可选) | 不计算 |
训练时只用 ASSISTANT 部分算 loss——模型只学「如何当 AI」,不学「如何当人类」。USER 说的话是给定的条件,不需要学。
USER 的 token 参与了 attention 计算(模型看到了),只是不产生梯度。这和 CLIP 的对比学习思想类似——USER 部分是条件,ASSISTANT 部分才是要学的目标。
LLaVA 里的实际模板
LLaVA 使用 Vicuna 的 conversation 模板(llava/conversation.py):
conv_vicuna_v1 = Conversation(
    system = "A chat between a curious user and an AI assistant. ...",
    roles  = ("USER", "ASSISTANT"),
    sep    = " ",
    sep2   = "</s>",
)
sep(空格)是系统/用户说话后加的,sep2(</s>)是助理说话后加的。拼接出来就是:
A chat between a curious user and an AI assistant. ...
USER: <image>\n描述这张图</s>ASSISTANT:
LLM 看到这个前缀,自然续写描述。
多轮对话怎么工作
多轮对话就是交替拼接:
Round 1:  USER: 这是什么?      → 模型输出: 一只猫
Round 2:  USER: 什么颜色?      → 模型输出: 橘色

实际喂给 LLM 的 prompt:
"USER: 这是什么? ASSISTANT: 一只猫</s> USER: 什么颜色? ASSISTANT:"
                               ↑ 历史在 prompt 里                     ↑ 当前轮等续写
每一轮都把前面所有轮拼在一起重新输入。模型没有「记忆」,它的记忆就是前面的 token 序列。这就是 context window 的含义。
✎ 最后更新:2026-07-20
附录
CLIP 和 BLIP 的文本编码器有什么本质区别?
| CLIP | BLIP | |
|---|---|---|
| 文本端架构 | 纯编码器(encoder-only) | 编码器 + 解码器(encoder-decoder) |
| 能力 | 只能判断「图文配不配」 | 既能理解,也能生成 caption |
CLIP 的文本端只输出一个固定长度的向量,不能生成文字。BLIP 多了解码器,能从图像生成描述。
这也是 BLIP 能做 Bootstrapping 的前提——用自己的解码器给图片生成干净 caption,再用这些伪标签反过来训练自己。