这篇文章整理强化学习(Reinforcement Learning, RL)中最常用的一组基础概念,主线参考 Sutton & Barto 的 Chapters 1–6:先建立 agent–environment interaction 的时序,再介绍 MDP、value function、Bellman equation,最后比较 DP、MC 与 TD。
一句话概括:agent 根据当前信息选择 action,environment 返回 reward 和下一时刻的信息;RL 希望找到一个能让期望累计回报最大的 policy。
1. Agent–Environment Interaction
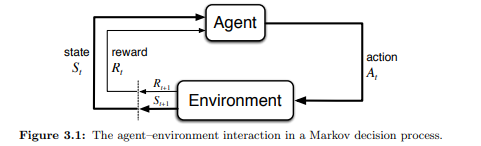
RL 的基本交互循环是:
$$ S_t \xrightarrow{\;A_t \sim \pi(\cdot \mid S_t)\;} (R_{t+1}, S_{t+1}) $$按照 Sutton & Barto 的下标约定,在时刻 $t$:
- agent 获得状态 $S_t$,或者只能看到 observation $O_t$;
- agent 按照 policy 选择动作 $A_t$;
- environment 执行动作,并返回 reward $R_{t+1}$ 与下一状态 $S_{t+1}$。
因此,一条完整 trajectory(也叫 rollout)可以写成:
$$ \tau = (S_0, A_0, R_1, S_1, A_1, R_2, \ldots) $$1.1 State 与 Observation
- Environment state $S_t$:对未来演化具有 Markov 性的环境信息。它不要求环境是确定性的;即使知道完整状态,下一状态仍然可以是随机的。
- Observation $O_t$:agent 实际能获得的信息,例如相机图像、关节角度或带噪传感器读数。
如果 $O_t$ 包含完整状态,则称为 fully observed;如果只能看到局部信息,则通常需要用 POMDP(Partially Observable MDP)描述。实际代码中,policy 经常写成 $\pi(a \mid s)$,但网络输入往往是 observation,即 $\pi(a \mid o)$。
1.2 Action
Action space 常见两类:
- Discrete action:动作来自有限集合。例如 Atari 中的上下左右,policy 网络通常为每个动作输出一个 logit,再通过 categorical distribution 采样。
- Continuous action:动作是实数向量,例如机器人各关节的 torque。policy 可以直接输出确定性动作,也可以参数化一个概率分布。
在 PPO 等 stochastic policy 方法中,continuous action policy 常用 diagonal Gaussian:网络输出均值 $\mu_\theta(o)$,标准差通常通过 $\log \sigma$ 参数化,然后采样
$$ A_t = \mu_\theta(O_t) + \sigma_\theta(O_t) \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I) $$但“continuous action = Gaussian policy”并不是定义,只是一种常见实现。
1.3 Reward 与 Policy
Reward $R_{t+1}$ 是 environment 对刚才那一步转移给出的标量反馈。agent 的目标不是贪心地最大化每一步 immediate reward,而是最大化整条 trajectory 的期望累计回报。
Policy $\pi$ 描述 agent 如何选择动作:
$$ A_t = \mu_\theta(S_t) \quad \text{(deterministic)}, \qquad A_t \sim \pi_\theta(\cdot \mid S_t) \quad \text{(stochastic)} $$2. Episodic、Continuing 与 Return
这里应使用 continuing,而不是 continuous:continuous 通常描述 action/state space 是否连续,continuing 描述任务是否自然结束。
- Episodic task:交互会到达 terminal state,例如棋局结束、机器人成功或失败。
- Continuing task:理论上持续运行,没有自然终点,例如持续的数据中心温控。
还要区分两种“episode 结束”:
- Termination:到达任务定义中的终止状态;此后没有未来回报,bootstrap 时令下一状态价值为 $0$。
- Truncation:由于外部时间限制或采样限制而停止,例如 wrapper 强制在 500 步截断;最后一个状态不一定是 terminal state,通常仍应 bootstrap。
2.1 Discounted Return
从时刻 $t$ 开始的 discounted return 定义为:
$$ G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1} $$其中 $\gamma \in [0,1]$ 是 discount factor:
- $\gamma = 0$:只关注 immediate reward;
- $\gamma$ 越接近 $1$:越重视长期回报;
- continuing task 通常取 $\gamma < 1$,使无限和在常见条件下保持有限;
- finite episodic task 在回报有限时可以取 $\gamma = 1$。
RL 的优化目标通常写成:
$$ J(\pi) = \mathbb{E}_{\tau \sim \pi}[G_0], \qquad \pi^* = \arg\max_\pi J(\pi) $$3. Value、Action-Value 与 Advantage
下面三个函数都依赖 policy $\pi$:
$$ V^\pi(s) = \mathbb{E}_\pi[G_t \mid S_t=s] $$$$ Q^\pi(s,a) = \mathbb{E}_\pi[G_t \mid S_t=s, A_t=a] $$$$ A^\pi(s,a) = Q^\pi(s,a) - V^\pi(s) $$- $V^\pi(s)$:位于状态 $s$,之后一直执行 $\pi$ 时的期望回报。
- $Q^\pi(s,a)$:先在 $s$ 执行动作 $a$,之后再一直执行 $\pi$ 时的期望回报。
- $A^\pi(s,a)$:动作 $a$ 相比当前 policy 在状态 $s$ 下的平均表现好多少。
对 discrete action,有:
$$ V^\pi(s) = \sum_a \pi(a \mid s)Q^\pi(s,a) $$一个具体数值例子
假设在某状态 $s$:
| Action | $\pi(a \mid s)$ | $Q^\pi(s,a)$ |
|---|---|---|
| left | $0.25$ | $2$ |
| right | $0.75$ | $5$ |
那么:
$$ V^\pi(s) = 0.25 \times 2 + 0.75 \times 5 = 4.25 $$所以 $A^\pi(s,\text{left})=-2.25$,$A^\pi(s,\text{right})=0.75$。并且 policy 下 advantage 的期望为零:
$$ \sum_a \pi(a \mid s)A^\pi(s,a)=0 $$4. Multi-Armed Bandit:最简化的 RL 问题
Sutton & Barto Chapter 2 先研究 multi-armed bandit。它可以看成没有状态转移、每次只选择一个 action 并立即得到 reward 的简化问题,核心矛盾是:
- Exploitation:选择当前估计最好的 action;
- Exploration:尝试不确定的 action,以免错过真正更好的选择。
若 $Q_n(a)$ 表示 action $a$ 的 reward estimate,则一次增量更新可以写成:
$$ Q_{n+1}(a) = Q_n(a) + \alpha_n\big(R_n-Q_n(a)\big) $$当 $\alpha_n=1/N_n(a)$ 时,它等价于 sample average;使用 constant step size 时则更容易追踪 non-stationary reward。这个“旧估计 + 步长 × 误差”的形式,后面会反复出现在 MC、TD、Q-learning 和 neural network optimization 中。
5. MDP(Markov Decision Process)
一个常见的 MDP 定义为五元组:
$$ \mathcal{M}=(\mathcal{S},\mathcal{A},P,R,\gamma) $$- $\mathcal{S}$:state space;
- $\mathcal{A}$:action space;
- $P(s'\mid s,a)$:transition probability;
- $R(s,a,s')=\mathbb{E}[R_{t+1}\mid S_t=s,A_t=a,S_{t+1}=s']$:期望 immediate reward;
- $\gamma$:discount factor。
初始状态通常还由分布 $\rho_0$ 给出。
5.1 Markov Property
Markov property 的准确含义是:给定当前 state 和 action,下一步的 state–reward 分布不再依赖更早的完整历史。
$$ P(S_{t+1},R_{t+1}\mid S_0,A_0,\ldots,S_t,A_t)=P(S_{t+1},R_{t+1}\mid S_t,A_t) $$这不代表 $S_t$ 能唯一确定 $S_{t+1}$;MDP 完全可以有 stochastic transition。它要求的是 $S_t$ 已经包含预测未来所需的充分信息。
MDP 是序列决策与 RL 的基本数学框架。Diffusion model 中也会使用 Markov chain,但不应把 diffusion process 本身直接等同于 MDP:MDP 额外包含 action、reward 与决策目标。
6. Bellman Expectation Equation
Bellman equation 的核心是把 return 拆成“一步 reward + 下一状态的剩余 return”:
$$ G_t = R_{t+1} + \gamma G_{t+1} $$6.1 State-Value Function
$$ V^\pi(s)=\mathbb{E}_\pi\left[R_{t+1}+\gamma V^\pi(S_{t+1})\mid S_t=s\right] $$若 state 和 action 都是离散的,则展开为:
$$ V^\pi(s)=\sum_a\pi(a\mid s)\sum_{s'}P(s'\mid s,a)\left[R(s,a,s')+\gamma V^\pi(s')\right] $$6.2 Action-Value Function
$$ Q^\pi(s,a)=\mathbb{E}_\pi\left[R_{t+1}+\gamma Q^\pi(S_{t+1},A_{t+1})\mid S_t=s,A_t=a\right] $$展开为:
$$ Q^\pi(s,a)=\sum_{s'}P(s'\mid s,a)\left[R(s,a,s')+\gamma\sum_{a'}\pi(a'\mid s')Q^\pi(s',a')\right] $$连续 state/action space 中,上面的求和需要改成积分。
如果把“下一步继续遵循 $\pi$”换成“下一步总选价值最大的动作”,就得到 Bellman optimality equation:
$$ Q^*(s,a)=\sum_{s'}P(s'\mid s,a)\left[R(s,a,s')+\gamma\max_{a'}Q^*(s',a')\right] $$这也是 Q-learning target 的来源。
7. DP、MC 与 TD:三种 Value Estimation 思路
三者都可以写成同一种增量形式:
$$ \text{new estimate}=\text{old estimate}+\alpha(\text{target}-\text{old estimate}) $$真正的差别在于:target 从哪里来,是否需要 environment model,以及是否 bootstrap。
| 方法 | 需要 $P,R$ 模型 | 何时更新 | 典型 target | Bootstrap | 典型特点 |
|---|---|---|---|---|---|
| DP | 是 | 反复 sweep states | 对所有下一状态求期望 | 是 | target 方差低,但需要完整模型 |
| MC | 否 | episode 结束后 | 实际采样到的 $G_t$ | 否 | target 通常无偏,但方差较高 |
| TD(0) | 否 | 每次 transition 后 | $R_{t+1}+\gamma V(S_{t+1})$ | 是 | 可在线更新,通常方差更低但 target 有偏 |
这里的“偏差/方差”描述的是有限样本和当前估计下的典型 target,并不等于对所有算法、函数逼近器和采样方式的无条件收敛保证。
7.1 Dynamic Programming(DP)
DP 假设 transition 和 reward model 已知,用 Bellman expectation backup 做 policy evaluation:
$$ V_{k+1}(s) \leftarrow \sum_a\pi(a\mid s)\sum_{s'}P(s'\mid s,a)\left[R(s,a,s')+\gamma V_k(s')\right] $$在 tabular setting 中,通常对状态反复 sweep 直到估计稳定。它不是从 sampled trajectory 学,而是直接对所有可能的下一状态求期望。
7.2 Monte Carlo(MC)
MC 等 episode 结束后,用实际 return 更新:
$$ V(S_t) \leftarrow V(S_t)+\alpha\left[G_t-V(S_t)\right] $$在 on-policy sampling 下,$G_t$ 是 $V^\pi(S_t)$ 的随机样本;它不依赖当前的 value estimate,因此不 bootstrap。它的主要问题是必须等到 episode 结束,而且长 trajectory 中随机 reward 的累积会带来较高方差。
注意:这条式子更新的是 value estimate,不是直接更新 policy parameters。MC control 会另外使用 estimated action values 来改进 policy。
7.3 Temporal-Difference Learning(TD)
TD(0) 每得到一个 transition 就更新:
$$ V(S_t) \leftarrow V(S_t)+\alpha\underbrace{\left[R_{t+1}+\gamma V(S_{t+1})-V(S_t)\right]}_{\delta_t\;\text{(TD error)}} $$TD target 使用了尚未完全准确的 $V(S_{t+1})$,所以它在 bootstrap;代价是引入偏差,收益是无需等待 episode 结束,并且通常比完整 return 的方差低。
例如,若 $\gamma=0.9$、$R_{t+1}=2$、$V(S_{t+1})=5$、$V(S_t)=4$、$\alpha=0.1$,则:
$$ \delta_t=2+0.9\times5-4=2.5, \qquad V(S_t)\leftarrow4+0.1\times2.5=4.25 $$到达真正的 terminal state 时令下一状态价值为 $0$;若只是 truncation,则通常仍应使用下一状态价值进行 bootstrap。
8. 常见易错点
- Reward 与 return 不同:$R_{t+1}$ 是一步反馈,$G_t$ 是从当前时刻开始的累计回报。
- State 不等于 observation:fully observed 时二者可以相同,partially observed 时 agent 只拿到 $O_t$。
- Markov 不等于 deterministic:Markov property 约束条件依赖关系,不要求下一状态唯一。
- Continuing 不等于 continuous:前者描述任务是否终止,后者通常描述 state/action space。
- Termination 不等于 truncation:二者决定 terminal transition 是否应该 bootstrap。
- MC 不一定更新 policy:MC prediction 只估计 value;MC control 才同时改进 policy。
1. 从 $(S_t,A_t)$ 转移后得到的是 $R_t$ 还是 $R_{t+1}$?
按本文采用的 Sutton & Barto 约定,environment 返回 $R_{t+1}$ 和 $S_{t+1}$。
3. MC 与 TD 最核心的区别是什么?
MC 使用完整 sampled return $G_t$,不 bootstrap;TD 使用 $R_{t+1}+\gamma V(S_{t+1})$,会 bootstrap,并且可以在 episode 结束前更新。
参考资料
- Richard S. Sutton & Andrew G. Barto, Reinforcement Learning: An Introduction, 2nd Edition,重点是 Chapters 1–6。
- OpenAI Spinning Up, Part 1: Key Concepts in RL,适合复习 policy、trajectory、return 与 value function。
- Gymnasium, Handling Time Limits,解释 termination、truncation 与 bootstrap 的区别。