Transformer
本篇文章是在学习 VLA 的过程中, 对 Transformer 等相关概念重新复习整理。代码分析全部基于 NanoGPT。
建议配合 Andrej Karpathy 的 YouTube 视频 Let’s build GPT: from scratch, in code, spelled out.
在开始之前我们稍微提一下什么是 Transformer,最重要的就是我们常听到的 Q、K、V 三个部分:
- Q (Query):当前 token 的「查询向量」,和每一个 key 做点积得到 affinity(相似性)
- K (Key):每个 token 的「键向量」,供 query 来匹配——「我有什么信息」
- V (Value):每个 token 的「值向量」,匹配成功后实际取出的内容——「找到后给你什么」
如果做的是 cross-attention,Q 来自当前序列,K/V 来自另一个输入序列(如 encoder 的输出)。
0. Introduction
我们从简单的例子开始着手,下面所讲的 BigramLanguageModel 每一次 generate 一个 chr,这里也讲一下简单的数据处理吧。
下面所有的代码都在这个repo里 : https://github.com/Ursu1e/perchar_LanguageModel.
首先我们的 dataset 是:
https://raw.githubusercontent.com/karpathy/char-rnn/master/data/tinyshakespeare/input.txt.
里面的都是Shakespeare的语料(对话形式).
因为我们是以 chr 为 token 单位的,那么根据统计有:
print(input_file_path)
with open(input_file_path, 'r') as f:
    data = f.read()
print(len(data))  # 文件中的 char number
# /Users/ursule/Desktop/embodied_ai/dl/bigram/data/input.txt
# 1115394
1115394 个字符。split 为 90% train_data,10% val_data。
那么我们现在有了训练集和验证集,接着思考:怎么判断我们是否预测正确呢,也就是如何训练?
1. 引出 vocab_size:我们所有可输出/读取的 token 个数。
vocab = sorted(list(set(data)))
vocab_size = len(vocab)
# 65
#  !$&',-.3:;?ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz
那么如何对应?我读到 x 和 X 如何区分?在这里比较简单:
def encode(s):  # s : a str
    return [stoi[ch] for ch in s]

def decode(s):  # s : a list of int
    return ''.join([itos[i] for i in s])
到此为止我们有了原来的 chr 映射到别的 space 的方式了。
2. 如何学习到这种相关联系呢?
如果你只是 shape [1, 1] 的 feature,可学习的参数就只有 1 个,因此我们引入了 nn.Embedding(vocab_size, n_embd)。
class BigramLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
我们把每一个 chr 映射成 [1, n_embd] 的 shape,自然可以学到更多的 feature 了。
先说一下 target 和 context 的关系:
start = random.randint(0, len(train_data) - 2 * l)
target  = train_data[start + 1 : start + 2 + l]
context = train_data[start : start + l + 1]

print(context)

for i in range(l):
    print(f'present context : {context[:(i + 1)]}')
    print(f'target: {target[i]}')

# tensor([ 0, 35, 53, 56, 58, 46, 63,  1, 57, 47, 56])
# present context : tensor([0])
# target: 35
# present context : tensor([ 0, 35])
# target: 53
# present context : tensor([ 0, 35, 53])
# target: 56
# present context : tensor([ 0, 35, 53, 56])
# target: 58
# present context : tensor([ 0, 35, 53, 56, 58])
# target: 46
# present context : tensor([ 0, 35, 53, 56, 58, 46])
# target: 63
# present context : tensor([ 0, 35, 53, 56, 58, 46, 63])
# target: 1
# present context : tensor([ 0, 35, 53, 56, 58, 46, 63,  1])
# target: 57
# present context : tensor([ 0, 35, 53, 56, 58, 46, 63,  1, 57])
# target: 47
# present context : tensor([ 0, 35, 53, 56, 58, 46, 63,  1, 57, 47])
# target: 56
注意:这里
present context是一个 list 不断变长,但我们现在实现的是只看前一个 chr 就 output 后面一个 chr(后续会做改进,可以显著降低 loss)。
接着定义 forward 过程:
    def forward(self, idx, targets=None):  # idx: (B,T)  targets: (B,T)
        logits = tok_emb = self.token_embedding_table(idx)
        if targets is None:
            return logits, None
        B, T, C = logits.shape
        logits = logits.view(B * T, C)
        targets = targets.view(B * T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss
targets is None是因为推理的时候当然没有target了; 以及我后续要 generate 看效果加的 如果只是train的话, 因为loss.backward()来更新所以一定要有target. 以及为什么要.view(), 可以看一下这篇里blog的cross_entropy:Torch 笔记.
训练过程
首先 get_batch: 也就是建一个dataloader
def get_batch(split):
    data = train_data if split == 'train' else val_data
    ix = np.random.randint(len(data) - block_size, size=(batch_size,))
    x = torch.stack([data[i : i + block_size] for i in ix])
    y = torch.stack([data[i + 1 : i + block_size + 1] for i in ix])
    return x, y

x, y = get_batch('train')
print(x.shape, '\n', x)  # [4,8] 数值为 [0,64] 的 tensor
print(y.shape, '\n', y)  # y 也一样
net = BigramLanguageModel()
optimizer = torch.optim.AdamW(net.parameters(), lr=lr)

for _ in range(epoch + 1):
    x, y = get_batch('train')
    logits, loss = net(x, y)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if _ % 100 == 0:
        print(f'epoch : {_} / {epoch} , loss : {loss.item()}')
epoch : 0 / 1000 , loss : 4.5313849449157715
epoch : 100 / 1000 , loss : 2.833672285079956
epoch : 200 / 1000 , loss : 3.1917784214019775
epoch : 300 / 1000 , loss : 2.570387125015259
epoch : 400 / 1000 , loss : 2.5198593139648438
epoch : 500 / 1000 , loss : 3.0866682529449463
epoch : 600 / 1000 , loss : 2.294440984725952
epoch : 700 / 1000 , loss : 2.557793378829956
epoch : 800 / 1000 , loss : 2.253950595855713
epoch : 900 / 1000 , loss : 2.53438138961792
epoch : 1000 / 1000 , loss : 2.800685405731201
可以看到 loss 是有下降的,但是不稳定。那么我们先测试一下现在的 output 结果如何:
def generate(idx, max_new_tokens):
    for _ in range(max_new_tokens):
        idx_cond = idx[:, -block_size:]
        logits, _ = net(idx_cond, None)         # logits: (B,T,C)
        logits = logits[:, -1, :]                # 只需要最后一个 chr
        probs = F.softmax(logits, dim=-1)        # 概率分布
        idx_next = torch.multinomial(probs, num_samples=1)  # 概率采样,保留随机性
        idx = torch.cat((idx, idx_next), dim=1)
    return idx

context = torch.zeros((1, 1), dtype=torch.long)
print(decode(generate(context, max_new_tokens=100)[0].tolist()))
后续的测试都沿用这个
generate代码,不再重复说明。
看一下 output 吧:
IUSA:
ARICEMure thalerd my sope, an m RKIshe ante, d,
EGOStrshefanceny the breghe gus wourspra daco
可以看到不太理想 :( 但是我们也可以看到有 she an my 等等词汇出现了,证明训练产生了效果. 但是看一下最开始的随机 output做一个对比的话:
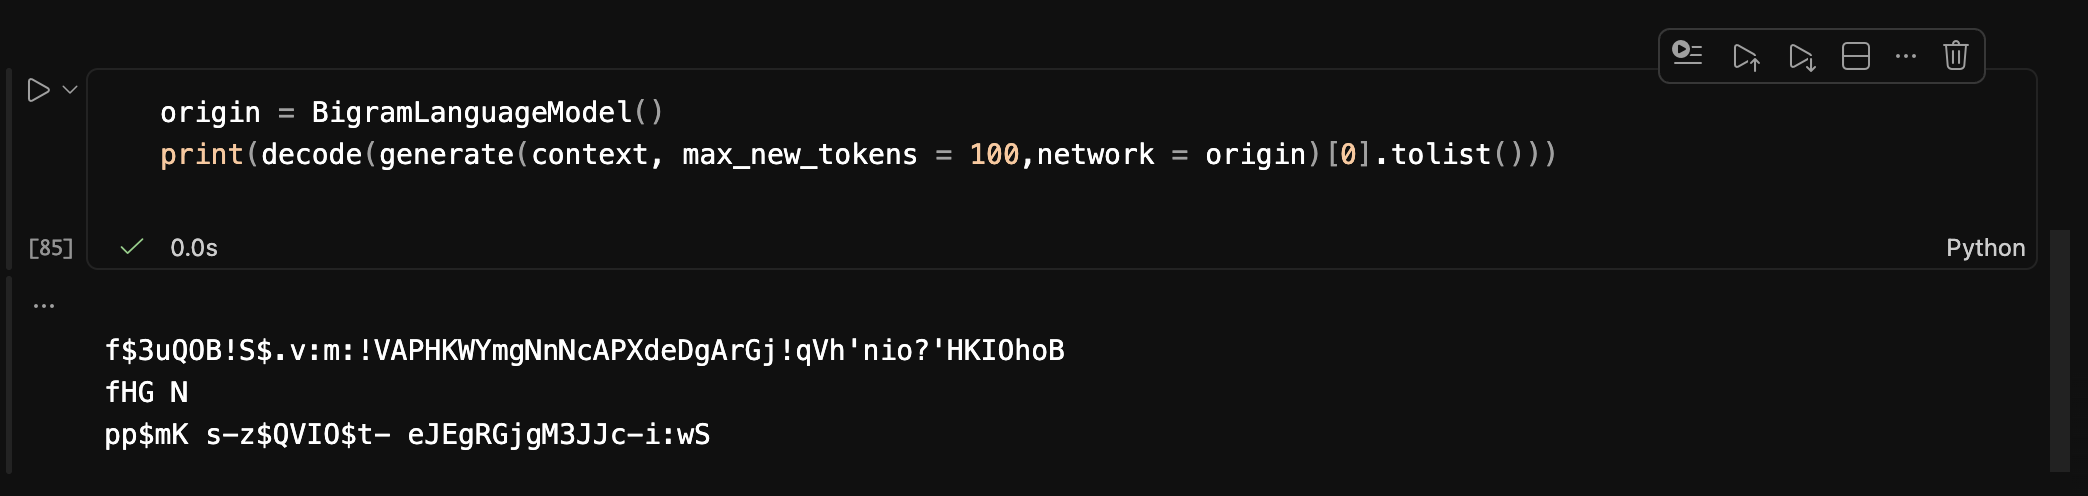
:P 看到还是进步非常明显的
好的,现在这还和 attention 机制无关。那么我们现在开始逐步添加组件,看看 loss 会有什么变化。
在 attention 之前我们做一些解释:
- positional_embedding:区别不同的位置, 否则同一个chr在不同的位置的效果是一样的
- Linear Projection:让 logits(
tok_emb)映射回vocab_size的维度,这样embedding_size就可以是(vocab_size, n_embd)了
看一下 loss :) 有下降就是好事:
epoch : 4000 / train_loss : 2.5523 , val_loss : 2.5515
epoch : 4200 / train_loss : 2.5405 , val_loss : 2.5484
epoch : 4400 / train_loss : 2.5275 , val_loss : 2.6062
epoch : 4600 / train_loss : 2.5365 , val_loss : 2.5414
epoch : 4800 / train_loss : 2.5421 , val_loss : 2.5349
...
epoch : 9400 / train_loss : 2.5366 , val_loss : 2.5643
epoch : 9600 / train_loss : 2.5396 , val_loss : 2.6035
epoch : 9800 / train_loss : 2.5147 , val_loss : 2.5607
epoch : 10000 / train_loss : 2.5434 , val_loss : 2.5264
好消息是还挺明显的稳定在 2.5 ~ 2.6 之间。
Masked Attention
我们都知道 BERT 是一个 bidirectional 的 language model,训练的时候不需要 masked attention;但 GPT 是一个 decoder-only transformer,训练的时候用的是 masked attention,也就是在当前步只能看历史信息。
k = 3
tril = torch.tril(torch.ones(k, k))
wei = torch.zeros((k, k))
wei = wei.masked_fill(tril == 0, float('-inf'))
wei = F.softmax(wei, dim=-1)
wei

# tensor([[1.0000, 0.0000, 0.0000],
#         [0.5000, 0.5000, 0.0000],
#         [0.3333, 0.3333, 0.3333]])
那么在 attention 里,就是我们的 query 对每一个 key 做 softmax 的时候只能看历史信息,而无法看未来的信息。
$$ \text{Attention}(Q, K, V) = \text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right) V $$那我们接下来根据计算公式以及刚才说的 softmax 公式来给出相关代码,先给出单层单头 QKV 版本(代码会有些冗余,只是为了方便理解):
class BigramLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.positional_embedding_table = nn.Embedding(block_size, n_embd)
        self.qkv = nn.Linear(n_embd, 3 * n_embd)

    def forward(self, idx, targets=None):  # idx: (B,T)  targets: (B,T)
        B, T = idx.shape
        tok_emb = self.token_embedding_table(idx)
        pos_emb = self.positional_embedding_table(torch.arange(T))
        x = tok_emb + pos_emb
        q, k, v = self.qkv(x).split(n_embd, dim=-1)
        wei = q @ k.transpose(-2, -1) * (n_embd ** -0.5)
        tril = torch.tril(torch.ones(T, T))
        wei = wei.masked_fill(tril == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)
        x = wei @ v
        logits = self.lm_head(x)
        if targets is None:
            return logits, None
        B, T, C = logits.shape
        logits = logits.view(B * T, C)
        targets = targets.view(B * T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss
现在我们所有的组件都已介绍完毕,接下来我们要做的就是 make net deeper。
不要忘记归一化
* (n_embd ** -0.5)— 把 QK 点积方差控制住,防止 softmax 饱和.
接下来给出一个更加工程化的写法,也是在别的 transformer 库非常常见的写法(无flash attention版)
class Head(nn.Module):
    """单头注意力"""
    def __init__(self, head_size):
        super().__init__()
        self.key   = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        q, k, v = self.query(x), self.key(x), self.value(x)
        wei = q @ k.transpose(-2, -1) * (n_embd ** -0.5)
        wei = F.softmax(wei.masked_fill(self.tril == 0, float('-inf')), dim=-1)
        out = wei @ v
        return out


class BigramLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.positional_embedding_table = nn.Embedding(block_size, n_embd)
        self.sa_head = Head(n_embd)

    def forward(self, idx, targets=None):
        B, T = idx.shape
        tok_emb = self.token_embedding_table(idx)
        pos_emb = self.positional_embedding_table(torch.arange(T))
        x = self.sa_head(tok_emb + pos_emb)
        logits = self.lm_head(x)

        if targets is None:
            return logits, None
        B, T, C = logits.shape
        logits = logits.view(B * T, C)
        targets = targets.view(B * T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss
MultiHeadAttention
写法类比,假设 head_num = 4:
class Head(nn.Module):
    """单头注意力"""
    def __init__(self, head_size):
        super().__init__()
        self.key   = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        q, k, v = self.query(x), self.key(x), self.value(x)
        wei = q @ k.transpose(-2, -1) * (n_embd ** -0.5)
        wei = F.softmax(wei.masked_fill(self.tril == 0, float('-inf')), dim=-1)
        out = wei @ v
        return out


class MultiHeadAttention(nn.Module):
    def __init__(self, num_heads, head_size):
        super().__init__()
        self.heads = nn.ModuleList([Head(head_size) for _ in range(num_heads)])

    def forward(self, x):
        out = torch.cat([h(x) for h in self.heads], dim=-1)
        return out


class BigramLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.positional_embedding_table = nn.Embedding(block_size, n_embd)
        self.sa_head = MultiHeadAttention(head_num, n_embd // head_num)

    def forward(self, idx, targets=None):
        B, T = idx.shape
        tok_emb = self.token_embedding_table(idx)
        pos_emb = self.positional_embedding_table(torch.arange(T))
        x = self.sa_head(tok_emb + pos_emb)
        logits = self.lm_head(x)

        if targets is None:
            return logits, None
        B, T, C = logits.shape
        logits = logits.view(B * T, C)
        targets = targets.view(B * T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss
loss 也的确降低了,而且其实还比较显著:
epoch : 4000 / train_loss : 2.2309 , val_loss : 2.2435
epoch : 4200 / train_loss : 2.1731 , val_loss : 2.2517
epoch : 4400 / train_loss : 2.2128 , val_loss : 2.2607
epoch : 4600 / train_loss : 2.2017 , val_loss : 2.2013
epoch : 4800 / train_loss : 2.1918 , val_loss : 2.2400
...
epoch : 9400 / train_loss : 2.0558 , val_loss : 2.1764
epoch : 9600 / train_loss : 2.0724 , val_loss : 2.1325
epoch : 9800 / train_loss : 2.0905 , val_loss : 2.1792

output →
LOLEO:
I ancaresell, dame:
I YOLE:
VoTt therges and hings thanguare bonieen by dout my msa? of junes
最终版本:+ Residual + LayerNorm
我的最终代码加上了 residual(残差连接)和 LayerNorm 这两个常见的(原论文也提到了的)模块。整个框架如下:
class Head(nn.Module):
    """单头注意力"""
    def __init__(self, head_size):
        super().__init__()
        self.key   = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)

    def forward(self, x):
        B, T, C = x.shape
        tril = torch.tril(torch.ones(T, T, device=device))
        q, k, v = self.query(x), self.key(x), self.value(x)
        _,_,c = q.shape
        wei = q @ k.transpose(-2, -1) * (c ** -0.5) ## 这里注意不是传n_embd 因为已经不是单头了
        wei = F.softmax(wei.masked_fill(tril == 0, float('-inf')), dim=-1)
        out = wei @ v
        return out


class MultiHeadAttention(nn.Module):
    def __init__(self, num_heads, head_size):
        super().__init__()
        self.heads = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)

    def forward(self, x):
        out = torch.cat([h(x) for h in self.heads], dim=-1)
        out = self.proj(out)
        return out


class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, n_embd * 4),
            nn.ReLU(),
            nn.Linear(n_embd * 4, n_embd)
        )

    def forward(self, x):
        return self.net(x)


class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        head_size = n_embd // n_head
        self.sa_head = MultiHeadAttention(n_head, head_size)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        x = x + self.sa_head(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x


class BigramLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.positional_embedding_table = nn.Embedding(block_size, n_embd, device=device)
        self.blocks = nn.Sequential(
            Block(n_embd, head_num),
            Block(n_embd, head_num),
            Block(n_embd, head_num),
            nn.LayerNorm(n_embd)
        )

    def forward(self, idx, targets=None):
        B, T = idx.shape
        tok_emb = self.token_embedding_table(idx)
        pos_emb = self.positional_embedding_table(torch.arange(T))
        x = tok_emb + pos_emb
        x = self.blocks(x)
        logits = self.lm_head(x)

        if targets is None:
            return logits, None
        B, T, C = logits.shape
        logits = logits.view(B * T, C)
        targets = targets.view(B * T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss
训练结果:
epoch : 4400 / train_loss : 2.1809 , val_loss : 2.1722
epoch : 4600 / train_loss : 2.1541 , val_loss : 2.1836
epoch : 4800 / train_loss : 2.0982 , val_loss : 2.1603
...
epoch : 9400 / train_loss : 2.0322 , val_loss : 2.0990
epoch : 9600 / train_loss : 2.0046 , val_loss : 2.1106
epoch : 9800 / train_loss : 2.0304 , val_loss : 2.1059
epoch : 10000 / train_loss : 2.0467 , val_loss : 2.1061


Cles deiser pile,
And and show I make tobe caten, fear too pite wo alf
my faight; die's me diecs, is
可以看到已经比较像英文了。至此这个小的 network 就完成了,后续 Karpathy 训练了一个更大的 network 在 A100 上, 但是目前对复习和了解各个组件已经足够了 :)
为了保持完整性,我们也进行一下模型参数保存
torch.save(model.state_dict(),'./checkpoint/nanogpt.pth') ## save pth (model 改成你自己想要保存的实例名称)
test_model = BigramLanguageModel()
test_model.load_state_dict(torch.load('./checkpoint/nanogpt.pth'))
print(estimate_loss(test_model))
print(decode(generate(context, max_new_tokens = 100,network = test_model)[0].tolist())) ## 你需要对generate函数做改变让它显式传入参数
torch.save不会保存优化器参数, 如果想要完整复刻(但是没有必要,eval的时候不更新参数)
torch.save({
    'model_state_dict': model.state_dict(),
    'optimizer_state_dict': optimizer.state_dict(),
    'epoch': epoch,
}, 'checkpoint.pth')
checkpoint = torch.load('checkpoint.pth')
model.load_state_dict(checkpoint['model_state_dict'])
optimizer.load_state_dict(checkpoint['optimizer_state_dict'])
output:
{'train': tensor(2.0282), 'val': tensor(2.0970)}

of lord, are and thing bids eap gther your bet? birge soumpon be for
MEoth seall I kingled! I shricc
概念回顾 — From NanoGPT
以下部分是对 NanoGPT 源码中各关键组件的精读笔记。
1. Config — 关键参数
@dataclass  # model.py line 108+, dataclass 替代 __init__ 的常见写法
class GPTConfig:
    block_size: int = 1024
    vocab_size: int = 50304   # GPT-2 实际 50257, 补齐到 64 的倍数提升效率
    n_layer: int = 12
    n_head: int = 12
    n_embd: int = 768
    dropout: float = 0.0
    bias: bool = True          # True: GPT-2 风格; False: 略快略好
| 参数 | 含义 |
|---|---|
n_head | 多头注意力的头数,需满足 n_embd % n_head == 0 |
n_layer | transformer block 的堆叠层数(类似 ViT 中不同层处理不同粒度的语义) |
n_embd | 每个 token 的 embedding 维度 |
vocab_size | 词表大小,决定了模型「认识」多少 token。生僻词会通过 BPE 拆分为子词表示 |
block_size | 一次前向能看到的最大上下文长度(训练时上下文窗口) |
BPE 与 tokenization:GPT 常用 BPE(byte pair encoding),遇到生词继续拆分为子词(subword),Google 的 SentencePiece 也是类似思路。BPE 的 trade-off:词表越大 → 拆分越少 → 同样的文本 tokenize 后序列越短,但词表本身也占参数。
block_size 由什么决定?
- 显存(HBM):self-attention 的 $QK^\top$ 矩阵复杂度为 $O(T^2 C)$,长序列会撑爆显存
- 计算量:attention 的 FLOPs 与 $T^2$ 成正比(详见下文瓶颈分析表)
常见解决方案:Flash Attention、KV cache 压缩、RoPE 位置编码等,可以突破原始
block_size的限制。
位置编码为什么必要? Attention 本身对 token 位置不敏感——把序列打乱,QK 点积结果不变。因此需要给每个位置的 embedding 注入位置信息(正弦编码或可学习向量),模型才能区分「第一个词」和「最后一个词」。
2. LayerNorm — 训练稳定
class LayerNorm(nn.Module):
    """LayerNorm but with an optional bias. PyTorch doesn't support simply bias=False"""
    # 注:新版 PyTorch 已支持 nn.LayerNorm(dim, bias=False)

    def __init__(self, ndim, bias):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(ndim))
        self.bias   = nn.Parameter(torch.zeros(ndim)) if bias else None

    def forward(self, input):
        return F.layer_norm(input, self.weight.shape, self.weight, self.bias, 1e-5)
LayerNorm 有两个参数分别是 $\gamma \beta$ 并且还需要算出mean和var 后面很多模型都用的是RMSNorm 只用算mean(x^2) 以及 $\gamma$ , 见下文
作用就是训练稳定:
- 数值归一化,防止数值爆炸/消失
- 梯度更平滑,允许更大的学习率
- 加速收敛
3. Attention — 核心机制
class CausalSelfAttention(nn.Module):

    def forward(self, x):
        B, T, C = x.size()  # batch, seq_len, n_embd

        # QKV 投影 + 分头
        q, k, v = self.c_attn(x).split(self.n_embd, dim=2)
        k = k.view(B, T, self.n_head, C // self.n_head).transpose(1, 2)  # (B, nh, T, hs)
        q = q.view(B, T, self.n_head, C // self.n_head).transpose(1, 2)  # (B, nh, T, hs)
        v = v.view(B, T, self.n_head, C // self.n_head).transpose(1, 2)  # (B, nh, T, hs)

        if self.flash:
            # Flash Attention CUDA kernel (高效实现)
            y = F.scaled_dot_product_attention(
                q, k, v,
                attn_mask=None,
                dropout_p=self.dropout if self.training else 0,
                is_causal=True
            )
        else:
            # 手动实现
            att = (q @ k.transpose(-2, -1)) * (1.0 / math.sqrt(k.size(-1)))
            att = att.masked_fill(self.bias[:, :, :T, :T] == 0, float('-inf'))
            att = F.softmax(att, dim=-1)
            att = self.attn_dropout(att)
            y = att @ v  # (B, nh, T, T) x (B, nh, T, hs) -> (B, nh, T, hs)

        # 拼回头 + 输出投影
        y = y.transpose(1, 2).contiguous().view(B, T, C)
        y = self.resid_dropout(self.c_proj(y))
        return y
3.1 整体 shape 流转
| Shape | 说明 |
|---|---|
(B, T) | 输入的 token IDs |
↓ embedding | |
(B, T, n_embd) | 每个 token 映射为 n_embd 维向量 |
↓ transformer blocks | 纯特征变换,不存在 class 概念 |
(B, T, n_embd) | 最后的 hidden state |
↓ lm_head | Linear: n_embd → vocab_size |
(B, T, vocab_size) | logits(这里 C = vocab_size) |
↓ cross_entropy | |
| scalar | loss |
中间的 transformer 层全部在特征空间内做信息融合与提取,只有最后的 lm_head 投影后才产生分类维度,才能算 loss。
3.2 input 与 target 的构造
自回归语言模型的核心任务:已知前面的 token,预测下一个 token。训练时 input 和 target 是同一段文本错位一位:
原始 token 序列: [w1, w2, w3, w4, w5, w6]

input:   [w1, w2, w3, w4, w5]   ← 前 T 个
target:  [w2, w3, w4, w5, w6]   ← input 右移一位
即 target[:, t] = input[:, t+1]。每个位置都参与 loss 计算,不是只在序列末尾预测。
3.3 cross_entropy 的 view 操作
F.cross_entropy 要求 C(类别维)在 dim=1,但 transformer 输出 logits 的 C 在 dim=2,所以计算 loss 前必须 flatten:
logits:  (B, T, vocab_size)   →  .view(-1, vocab_size)  →  (B*T, C)    ← C 移到 dim=1
target:  (B, T)               →  .view(-1)              →  (B*T,)      ← 展平为 1D token IDs
loss = F.cross_entropy(logits.view(-1, vocab_size), targets.view(-1))
3.4 Attention 内部 shape 详解
- 输入 x:
[B, T, C]— batch size, 序列长度, embedding 维度 - QKV 投影:
c_attn(x)生成 q, k, v,三者尺寸相同[B, T, C] - 拆分为多头:$C \to n_h \times h_s$($h_s = C / n_h$),reshape + transpose 后为
[B, n_h, T, h_s] - 计算 Attention:
其中 $W^O \in \mathbb{R}^{h d_k \times d_{\text{model}}}$,$d_k = h_s = C / n_h$。
为什么除以 $\sqrt{d_k}$? 当 $d_k$ 较大时,$QK^\top$ 的点积方差膨胀至 $d_k$ 倍,softmax 输出趋于 one-hot(梯度消失)。除以 $\sqrt{d_k}$ 把方差拉回 1,保持梯度稳定。
多头 QK 矩阵的含义:每个头独立计算 $QK^\top$,从一个 $h_s$ 维子空间出发,得到该视角下的 token 间关联强度。拼接后模型同时在语法、语义、距离等多维度上理解序列。
Softmax 的意义:记 $E = QK^\top$,$E_{i,j}$ 是 token $i$ 对 token $j$ 的注意力分数。在
dim=-1做 softmax,得到每个 query 对所有可见 key 的概率分布,再用这个分布加权聚合 value——本质是**「从上下文中选择最相关的信息」**。输出投影:
c_proj融合多头的信息,恢复至[B, T, C]
Causal Mask(因果掩码):代码中
masked_fill(..., -inf)将上半三角置为 $-\infty$,softmax 后权重变 0。这确保第 $i$ 个 token 只能 attend 第 $1 \sim i$ 个 token(含自身),不能偷看未来。这是 GPT(自回归)和 BERT(双向)的根本区别。
3.5 计算瓶颈
| 操作 | 矩阵形状 | 复杂度 | 瓶颈类型 |
|---|---|---|---|
| QKV 投影 | $[T, C] \times [C, 3C]$ | $O(T C^2)$ | 内存带宽 |
| QK 乘法 | $[n_h, T, h_s] \times [n_h, h_s, T]$ | $O(T^2 C)$ | GPU 计算 |
| Output Proj | $[T, C] \times [C, C]$ | $O(T C^2)$ | 内存带宽 |
当上下文长度 $T$ 很大时,$T^2$ 是主导瓶颈。
4. MLP 与 Block — 组装
class MLP(nn.Module):

    def __init__(self, config):
        super().__init__()
        self.c_fc    = nn.Linear(config.n_embd, 4 * config.n_embd, bias=config.bias)
        self.gelu    = nn.GELU()
        self.c_proj  = nn.Linear(4 * config.n_embd, config.n_embd, bias=config.bias)
        self.dropout = nn.Dropout(config.dropout)

    def forward(self, x):
        x = self.c_fc(x)
        x = self.gelu(x)
        x = self.c_proj(x)
        x = self.dropout(x)
        return x


class Block(nn.Module):

    def __init__(self, config):
        super().__init__()
        self.ln_1 = LayerNorm(config.n_embd, bias=config.bias)
        self.attn = CausalSelfAttention(config)
        self.ln_2 = LayerNorm(config.n_embd, bias=config.bias)
        self.mlp  = MLP(config)

    def forward(self, x):
        x = x + self.attn(self.ln_1(x))
        x = x + self.mlp(self.ln_2(x))
        return x
Attention + MLP 的分工:
- Attention:token 之间的线性信息聚合(加权求和)→ 决定「从哪些 token 拿信息」
- MLP:对每个 token 独立做非线性变换 → 决定「拿到之后做什么处理」
二者互补,缺一不可。
设计细节:
- 4 倍 expansion(
4 × n_embd)是原论文的设计,GELU 比 ReLU 更平滑,梯度流动更好- 残差连接
x + Sublayer(LN(x))让梯度能直达底层,Pre-LN 的排列(LN 在 sublayer 前)进一步稳定训练,几十层也不退化
LLaMA 7B 关键组件
LLaMA 7B 是 LLaVA 等视觉语言模型使用的语言骨干网络。相比 NanoGPT 的 GPT-2 风格实现,LLaMA 有三个关键差异:
- SwiGLU — 代替 G/ReLU FFN
- RMSNorm — 代替 LayerNorm
- RoPE — 代替可学习位置编码
SwiGLU
SwiGLU 由 Swish 激活函数 + GLU(Gated Linear Unit)门控机制组成。
Swish 激活函数:
$$ \text{Swish}(x) = x \cdot \sigma(x) = \frac{x}{1 + e^{-x}} $$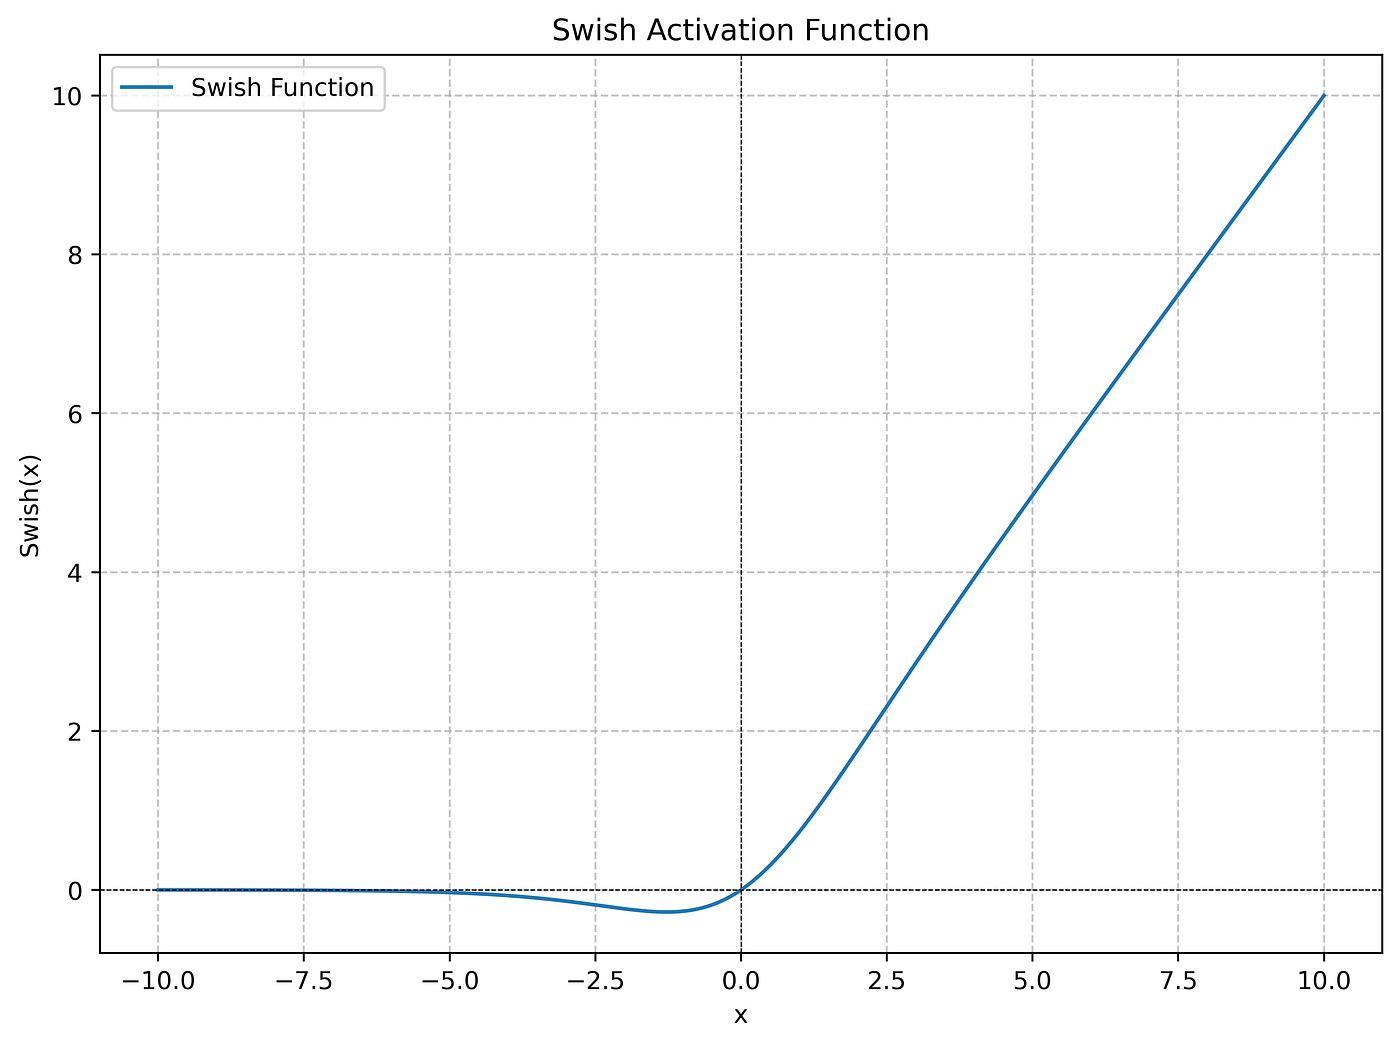
Swish 是 ReLU 的平滑替代:$x > 0$ 时不截断,$x < 0$ 时平滑衰减而非直接归零,梯度流动更稳定。
GLU(门控线性单元):
$$ \text{GLU}(x) = (xW_1 + b_1) \odot \sigma(xW_2 + b_2) $$GLU 把输入分两条路径:一条做普通线性变换,另一条过 sigmoid 门控(输出限制在 $(0, 1)$),两者逐元素相乘。门控路径起到「信息过滤器」的作用——sigmoid 接近 0 时抑制该维度,接近 1 时放行。
SwiGLU = Swish + GLU:
$$ \text{SwiGLU}(x) = \text{Swish}(xW_g + b_g) \odot (xW + b) $$注意:SwiGLU 有三组权重($W_g, W, b_g, b$),比 ReLU FFN 多一个线性层。为保持总参数量不变,hidden dimension 通常取 $\frac{2}{3} \times 4d$ 而非 $4d$。
实验表明 SwiGLU 在语言建模、翻译等任务上一致优于 ReLU FFN,已被 LLaMA、PaLM 等主流模型采用。
RMSNorm
RMSNorm(Root Mean Square Layer Normalization)是 LayerNorm 的简化版:
$$ \text{LayerNorm}(x) = \gamma \cdot \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} + \beta $$$$ \text{RMSNorm}(x) = \gamma \cdot \frac{x}{\sqrt{\text{mean}(x^2) + \epsilon}} $$核心区别:RMSNorm 去掉了「减均值」(re-centering),只做缩放(re-scaling)。
- 去掉 $\mu$ 和 $\beta$,计算量减少约 40%
- 实验证明 re-centering 对 LLM 训练并非必要,去掉后效果相当
- LLaMA 中 RMSNorm 放在 attention / FFN 之前(Pre-Norm),进一步提升训练稳定性
RoPE(旋转位置编码)
RoPE(Rotary Position Embedding)是 LLaMA 的核心位置编码方案。与 GPT-2 的「可学习位置 embedding」不同,RoPE 通过高维旋转将相对位置信息直接植入 Q 和 K 的内积中。
3.1 2D 旋转基础
2D 旋转矩阵 $R(\theta)$ 将一个向量逆时针旋转 $\theta$:
$$ R(\theta) = \begin{bmatrix} \cos\theta & -\sin\theta \\\\ \sin\theta & \cos\theta \end{bmatrix} $$$$ R(\theta) \cdot \begin{bmatrix} x \\\\ y \end{bmatrix} = \begin{bmatrix} x\cos\theta - y\sin\theta \\\\ x\sin\theta + y\cos\theta \end{bmatrix} $$用极坐标验证:设 $x = r\cos\phi, y = r\sin\phi$,代入得:
$$ R(\theta) \cdot v = \begin{bmatrix} r\cos(\phi + \theta) \\\\ r\sin(\phi + \theta) \end{bmatrix} $$即长度 $r$ 不变,角度从 $\phi$ 变为 $\phi + \theta$——逆时针旋转 $\theta$ 角度。$R(\theta)$ 是正交矩阵($R^\top = R^{-1}$),行列式为 1。
3.2 RoPE 的核心思想
给位置 $m$ 的 Q 旋转 $m\theta$,给位置 $n$ 的 K 旋转 $n\theta$:
$$ Q'_m = R(m\theta) \cdot Q_m, \quad K'_n = R(n\theta) \cdot K_n $$那么 Q 和 K 的内积:
$$ \begin{aligned} Q'_m{}^\top K'_n &= (R(m\theta)Q_m)^\top (R(n\theta)K_n) \\\\ &= Q_m^\top R(m\theta)^\top R(n\theta) K_n \\\\ &= Q_m^\top R(-m\theta) R(n\theta) K_n \quad (\text{转置 = 逆转}) \\\\ &= Q_m^\top R((n-m)\theta) K_n \end{aligned} $$关键性质:$Q_m^\top K_n$ 的内积只依赖相对位置 $\Delta = n - m$,不依赖绝对位置 $m$ 和 $n$。
3.3 多维推广:多频率
实际 Q/K 有 $d$ 维(LLaMA 7B 的 head_dim=128)。将 $d$ 维两两配对,一共 64 对,第 $i$ 对使用不同的旋转频率 $\theta_i$:
$$ \theta_i = 10000^{-2i/d}, \quad i = 0, 1, \dots, d/2 - 1 $$$\theta_i$ 从 $\theta_0 \approx 1.0$(高频)连续递减到 $\theta_{63} \approx 1/10000 \approx 0.0001$(低频)。
钟表类比
墙上钟表有三根针,转速不同,各自负责不同的时间精度:
| 针 | 速度(转一圈) | 能区分什么 | 不能区分什么 |
|---|---|---|---|
| 秒针 | 60 秒 | 精确到 1 秒 | 绕一圈回来,分不清第 1 还是第 2 分钟 |
| 分针 | 60 分钟 | 区分不同分钟 | 分不清上午还是下午 |
| 时针 | 12 小时 | 区分早上/下午 | 不够精确,分不出 12:01 和 12:02 |
三根针合在一起 = 精确到秒的绝对时间。单靠一根都不行。
RoPE 的 64 对维度就是 64 根「频率针」,从快到慢连续覆盖——没有任何一根能单独唯一编码位置,但 64 根合在一起,每个 $\Delta$ 对应一组独特的 $(\cos(\Delta\theta_0), \cos(\Delta\theta_1), \dots, \cos(\Delta\theta_{63}))$。
cos(Δθ) 可视化
简化成 3 对,观察 $\cos(\Delta \cdot \theta_i)$ 随 $\Delta$ 增大的变化:
Δ=0   Δ=1   Δ=2   Δ=3   Δ=4   Δ=5   Δ=6   ...   Δ=100  ...  Δ=200
─────────────────────────────────────────────────────────────────────

高频对 θ₀=1.0:
cos(Δ·1.0):  1.0  0.54 -0.42 -0.99 -0.65  0.28  0.96   ...   0.86   ...  0.49
             └── 剧烈震荡 ──┘           └── 绕了很多圈,cos 开始随机化 ──┘
Δ≤4: 超敏感,每个 Δ 的 cos 值都完全不同
Δ>4: 开始绕圈,cos 值不可靠(Δ=1 和 Δ≈7.3 的 cos 相同,无法区分)

中频对 θ₁=0.1:
cos(Δ·0.1):   1.0  0.99  0.98  0.95  0.92  0.88  0.83   ...   -0.84  ... 0.41
                                              └── 此时才绕不到两圈 ──┘
Δ≤10: cos≈1,几乎没反应
Δ≈10~60: 最有用!处在第一圈内,每个 Δ 唯一
Δ>60: 也开始绕圈

低频对 θ₂=0.001:
cos(Δ·0.001): 1.0 0.999 0.998 0.997 0.996 0.995 0.994  ...  0.995  ... 0.98
                                                      └── 转了这么久,还在第一圈 ──┘
Δ≤100: cos≈1,完全没反应
Δ≈100~1000: 唯一有用的范围!其他对早就绕飞了
合力:每个 Δ 都有几对在「敏感区」
Δ=1:  高频 cos(1·1.0)=0.540   ← "这是 Δ=1!"(在敏感区)
      中频 cos(1·0.1)=0.995   ← 跟 Δ=0 差不多(太慢,没反应)
      低频 cos(1·0.001)=0.999 ← 完全没反应(太慢)

Δ=10: 高频 cos(10·1.0)=-0.839 ← 早已绕飞(太快,cos 值不可靠)
      中频 cos(10·0.1)=0.540  ← "这是 Δ=10!"(在敏感区)
      低频 cos(10·0.001)=0.999 ← 依然没反应(太慢)

Δ=100:高频 cos(100·1.0)=0.862  ← 随机值(绕了太多圈)
      中频 cos(100·0.1)=-0.839 ← 绕飞了
      低频 cos(100·0.001)=0.995 ← "这是 Δ=100!"(在敏感区)
不管 Δ 多大,总至少有几对正在它们的「敏感区」内——不太快(绕圈了)也不太慢(cos≈1),cos 值落在 $[-1, 1]$ 的中间区,模型可以从中反推出 $\Delta$。
回到 LLaMA 7B(head_dim=128,64 对):
- 第 0~20 对(高频区):$\Delta=3$ → cos 值剧烈变动 → 提供精确的近距离信号
- 第 21~50 对(中频区):$\Delta=3$ → cos 微微变 → 提供辅助信号
- 第 51~63 对(低频区):$\Delta=3$ → $\cos \approx 1$ → 相当于没旋转,对近距离「麻木」
当 $\Delta$ 从 3 变成 300:前 20 对已绕上百圈(cos 是噪声),但第 51~63 对才开始有明显区分度。
为什么用 10000? 这个 base 控制频率衰减速度。base 越大,更多维度对落在中高频区 → 远程 attention 区分度越高。这就是 LLaMA 3 把 base 从 10000 提到 500000 的原因——在中距离上获得更精细的位置信号。
3.4 向量化实现
实际实现不是对每对维度分别乘 2×2 旋转矩阵,而是用向量化技巧一次完成:
def apply_rotary_emb(x, cos, sin):
    # x: (B, n_head, T, head_dim)
    d = x.shape[-1]
    # 把最后维拆成两半,前半视为 x 坐标,后半视为 y 坐标
    x_half = x.reshape(*x.shape[:-1], d // 2, 2)
    x1, x2 = x_half[..., 0], x_half[..., 1]

    # 每对用各自的 θᵢ 旋转
    x1_rot = x1 * cos - x2 * sin    # x' = x·cosθ - y·sinθ
    x2_rot = x1 * sin + x2 * cos    # y' = x·sinθ + y·cosθ

    return torch.stack([x1_rot, x2_rot], dim=-1).flatten(-2)
cos 和 sin 的形状为 [1, 1, T, d/2],每个位置、每个维度对使用对应的旋转角度。
3.5 为什么近处 token 自然获得更高 attention?
RoPE 本身不直接决定 attention 分数,而是提供一个计算相对距离的机制:
- $\Delta = 0$(同一位置):旋转角度差 = 0 → Q 和 K 方向完全对齐 → 内积 ≈ max
- $\Delta = 1$(紧邻):旋转角度差小 → 内积衰减很小
- $\Delta = 100$(远处):旋转角度差大 → 向量方向差异大 → 内积衰减大
两项都由模型在预训练中学出来。因果 mask 进一步加强了「近处优先」的归纳偏置——不需要手动调 RoPE 参数来保证近处 attention 更大。
3.6 外推:处理比训练时更长的序列
问题:LLaMA 1 训练最大长度 2048,推理时给 4096 token 会怎样?
低频分量(大 $i$,$\theta_i \approx 1/10000$)在训练中没见过的 $\Delta$ 下行为未知——低频最先崩溃。高频分量周期短,影响不大。
解决方案:
| 方法 | 做法 | 原理 |
|---|---|---|
| 增大 base | 10000 → 500000(LLaMA 3)或 1000000(Mistral) | $\theta_i$ 整体增大 → 相邻位置角度差拉大 → 对距离更敏感,天然支持更长上下文 |
| NTK-aware scaling | 推理时按比例放大 base | 只缩放高频,低频不变,等价于「假装」训练时看了更长序列 |
| YaRN | NTK + attention 温度缩放 | 额外除以 $\sqrt{t}$ 防止长上下文时注意力过度弥散 |
核心结论:增大 base 让远程 attention 更有区分度,但不会削弱近处——近处的旋转角度差也同步增大了。
3.7 RoPE vs 可学习位置编码
| GPT-2(可学习 PE) | LLaMA(RoPE) | |
|---|---|---|
| 位置注入方式 | $x = \text{tok\_emb} + \text{pos\_emb}$(加法) | $Q' = R(m\theta) \cdot Q$(旋转) |
| 相对位置 | 模型需间接学到 | 数学上天然保证 $Q_m^\top K_n = f(\Delta)$ |
| 外推能力 | 差(没见过的位置 ID 直接越界) | 好(旋转公式不变,只需算新角度) |
| 参数量 | $(max\_len, d)$ 可学习参数 | 无额外参数 |
RoPE 外推优于 GPT-2 的根本原因:GPT-2 遇到索引 2048 的位置 embedding 表直接越界;RoPE 只需计算新的旋转角度,旋转公式本身没变。
附录
补充说明
- GPT-2 的init部分 std = 0.02, mean = 0 但是在这个基础上的residual 部分是有问题的 因为std = 0.02 是试出来的一个比较合理的初始参数, 但是residual的问题是
x = torch.zeros(768)
n = 100
for i in range(n):
    x += torch.randn(768)
print(x.std())  # 10
所以我们要控制方差在1附近我们就需要 将N(0,n) * (n ** -0.5) 也就是
x += torch.randn(768) * (n ** -0.5)
# x.std() 在1附近
✎ 最后更新:2026-07-19